
評測環境的建置本身並不困難,pip install 加上幾行設定就能跑起來。真正花時間、也真正影響結果的,是測試案例的設計。
這裡存在一個常見的盲點:人工撰寫的測試案例,往往會繞著自己想得到的場景打轉。 我們會測試熟悉的用法、預期的參數組合,卻很容易忽略那些「不太可能但確實會發生」的邊界情況 —— 而模型偏偏最容易在那些地方出錯。
ADEval 對此提供了一個解法:gendata 指令可以直接連上 MCP Server,讀取完整的工具定義,再交由 Gemini 生成測試案例。讓模型讀完整份 Schema 之後自行發想,通常能撞出人工想不到的組合。
不過,四個刻意植入的難點仍然必須手寫,因為它們需要精心設計的前置狀態。
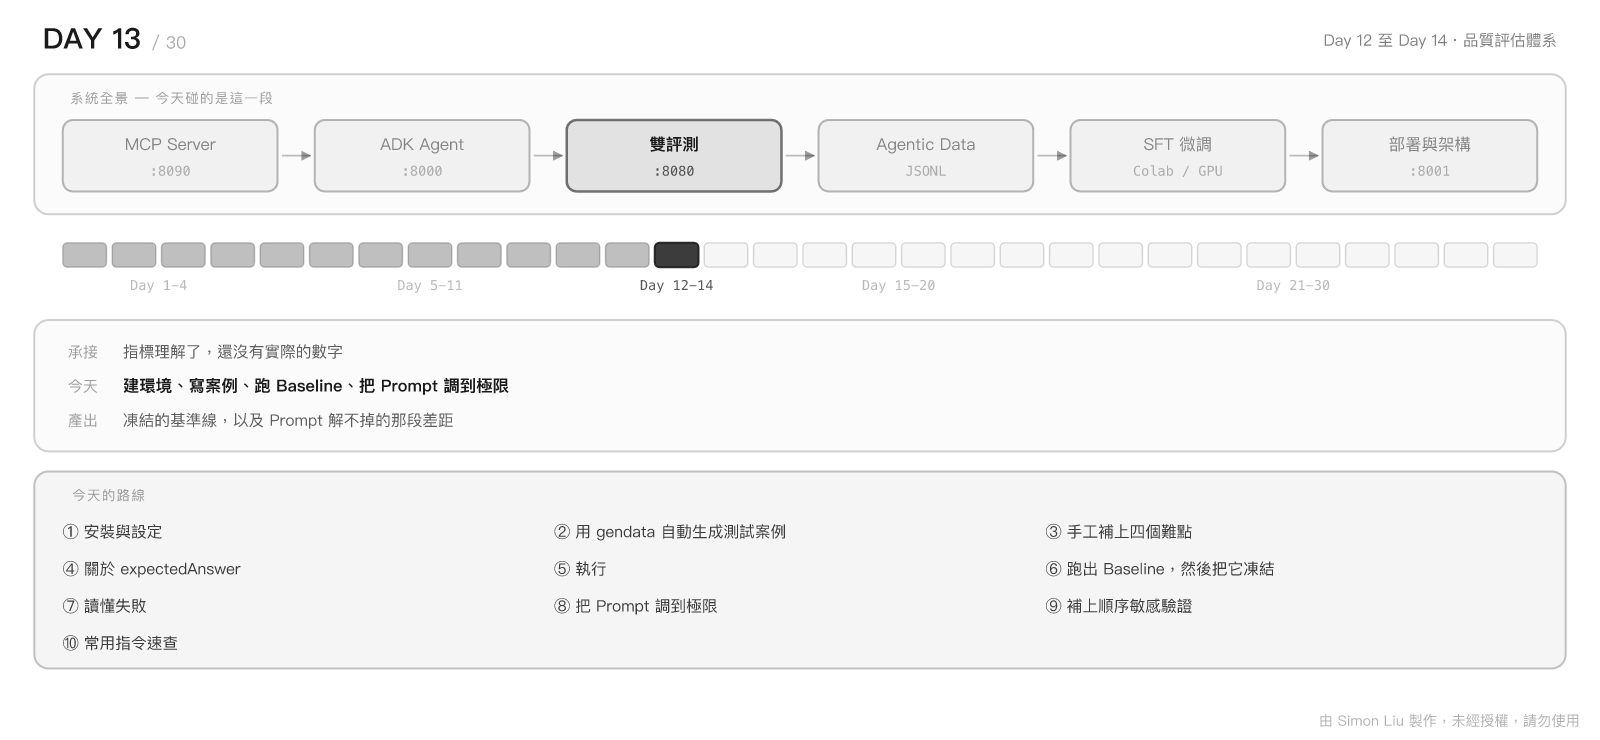
今天的份量比較重,因為這一天要一次走完評測的完整迴圈。 以下的內容,會從環境建置與測試案例設計開始,接著跑出並凍結 Baseline、逐案例讀懂失敗、把 Prompt 調校到收益遞減為止,最後動手補上 ADEval 目前缺的那一塊 —— 順序敏感的驗證。
走完之後,Day 1 承諾過的那條界線 —— Prompt 能解決的部分到哪裡為止、剩下多少要交給微調 —— 就會有具體的數字。
git clone https://github.com/ap-mic-inc/ADEval.git
cd ADEval
pip install -e .
或走 Docker:
docker build -t adeval:latest .

docker run -d \
  -p 8080:8080 \
  -v $(pwd)/.adeval:/app/data/.adeval \
  --name adeval \
  adeval:latest
掛載 volume 是必要的——實驗資料存在 .adeval/,不掛載的話容器一刪就沒了。
設定預設值,之後每個指令都不必重打:
adeval config --url "http://localhost:8000" --user "dev_01" --app "leave_copilot"
先確認能通:
adk api_server &                          # 另一個終端機
adeval test "有哪些未處理的假單?"
adeval test 不建立實驗,只跑單一問題,適合驗證連線。
手寫測試案例很慢。ADEval 可以直接連上 MCP Server,讀取工具定義,用 Gemini 生成案例:
adeval gendata --mcp http://127.0.0.1:8090/mcp \
  --num 30 \
  --tools 2 \
  --lang zh-tw \
  --app leave_copilot \
  --desc "企業差勤場景,包含假單查詢與狀態更新"
參數說明:
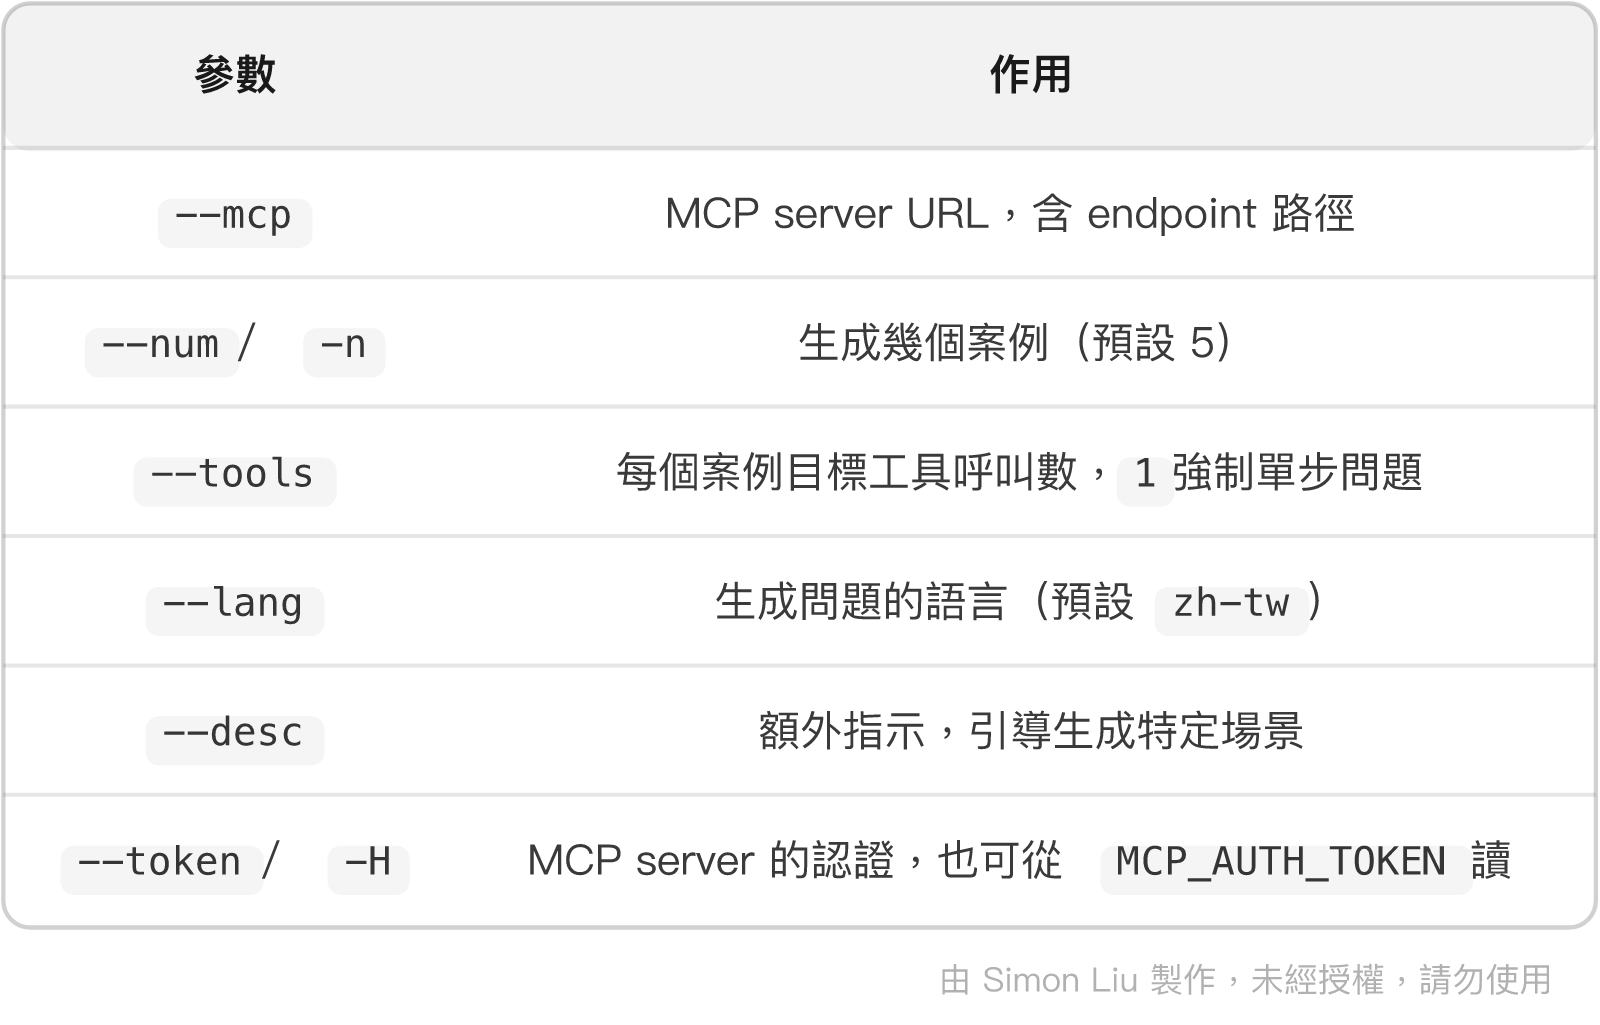
認證資訊只會在終端機回顯 header 名稱,不會顯示值。
這一步的價值在於覆蓋面。 手寫案例會不自覺地繞著您想得到的場景打轉;讓模型讀完整份工具 schema 再生成,容易撞出您沒想過的組合——例如同時帶三個選填參數的查詢。
--tools 1 和 --tools 2 分開跑兩批也值得,單步與多步的失敗模式不一樣。
gendata 生成的是「一般情況」的測試案例。至於四個難點,則必須手動撰寫 —— 因為它們各自需要精心設計的前置狀態,而這是自動生成無法處理的部分。
CSV 匯入:
adeval import leave_hard_cases.csv --name "四個難點基準"
各難點的設計要點:
問題刻意不給 ID,只給描述:
「把我那張家庭旅遊的特休送出審核」
預期工具:search_leaves, update_leave_status
失敗的樣子是直接呼叫 update_leave_status 並捏一個 ID。注意這種失敗在 name accuracy 上會被抓到(少了 search_leaves),但如果只看最終回答可能看不出來。
「撤銷小美那張已核准的病假」→ callback 回
decline
預期工具:cancel_approved_leave,且之後不得出現任何寫入工具。
這一項要靠 --mcp 的 read-only compliance 才量得準:
adeval stats <EXP_ID> --mcp http://127.0.0.1:8090/mcp
它讀 readOnlyHint,如果模型 decline 後改用 schedule_handover 繞道,會反映在合規分數上。
記得測 cancel。 decline 和 cancel 的正確反應不同(停止 vs 詢問),但很容易被混為一談。
前置狀態必須是 draft,然後:
「把 LV-7f3a91 直接核准」
預期是 update_leave_status(status="submitted")——因為不能跳級。
這一項必須開 Verify Args,否則只比對工具名稱的話,status="approved" 也會算通過。
「查八月二十號之後開始、還沒核准的假單」
預期 search_leaves 帶合法的 ISO 8601 start_after。同樣需要 Verify Args。
如果要用 Answer accuracy 這一項,測試案例需要 expectedAnswer 欄位,內容是實際執行預期工具得到的真實輸出。
沒有這個欄位的案例會被排除,而且該軸會從雷達圖上消失(不是顯示 0%)。看報表時要記得這件事,否則會誤判。
實務做法是先手動跑一次預期的工具序列,把回傳結果填進去。這很花時間,建議只為關鍵案例準備——四個難點各兩三個就夠了。
adeval inspect <EXP_ID>      # 先預覽,不執行
adeval run <EXP_ID> --verbose
--verbose 會在失敗時顯示完整的原始回應,診斷時必開。
adeval run <EXP_ID> --concurrency 4
看起來能加速四倍,但文件有明確警告:
Cases are independent (each mints its own session), but this is only safe against backends that tolerate concurrency — a self-hosted LiteLLM proxy often serialises requests, and one stuck case then times out every case behind it. Keep it at 1 for those.
自架的 LiteLLM proxy 常常會序列化請求,一個卡住的案例會讓後面全部逾時。系列後期評估本地部署的微調模型時特別要注意——自架推論框架的併發能力跟商業 API 不一樣,先用 -c 1 建立基準,確認能撐再往上加。
另外 --timeout 預設 120 秒,本地模型比較慢,可能要調高。
測試案例就位之後,跑第一次完整的評測:
adeval run <EXP_ID> --verbose
adeval stats <EXP_ID> --mcp http://127.0.0.1:8090/mcp --json > baseline.json
這組數字接下來會一路沿用到系列後期的驗收。而它能不能沿用,取決於一件事:這次執行的條件,之後能不能一模一樣地重現。
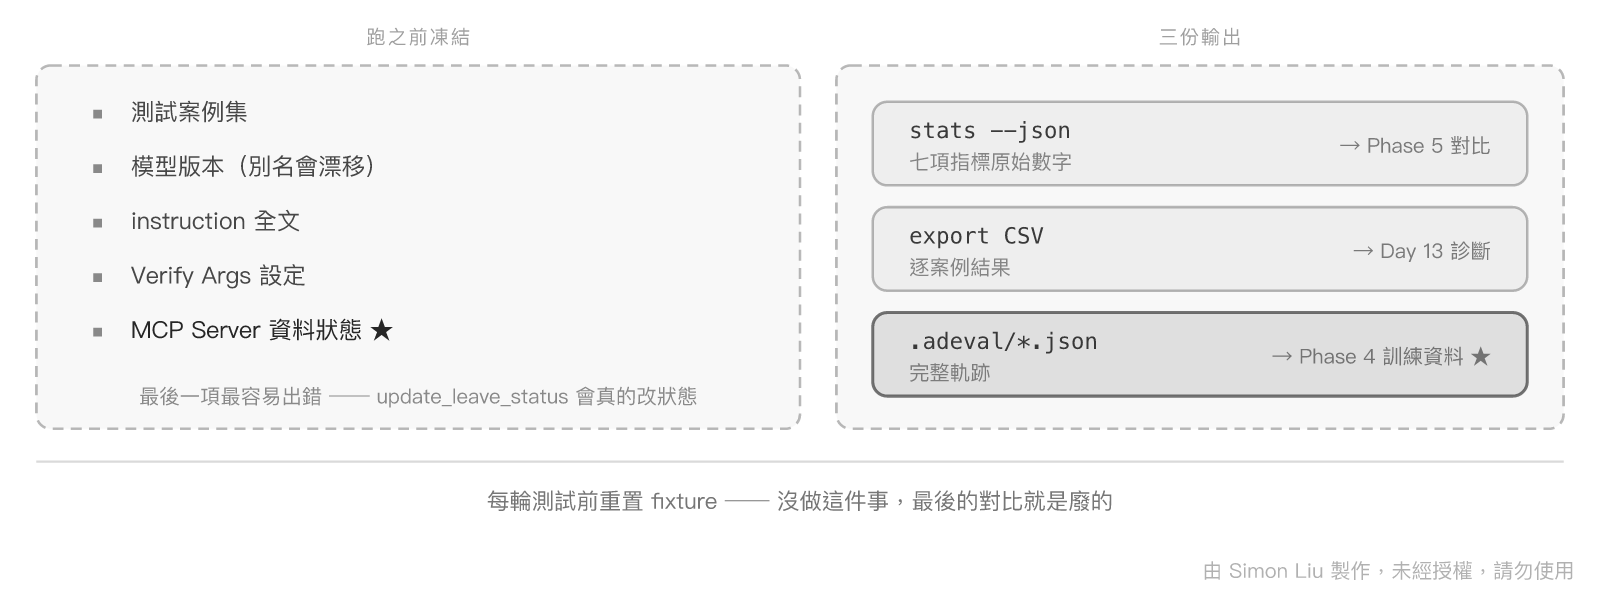
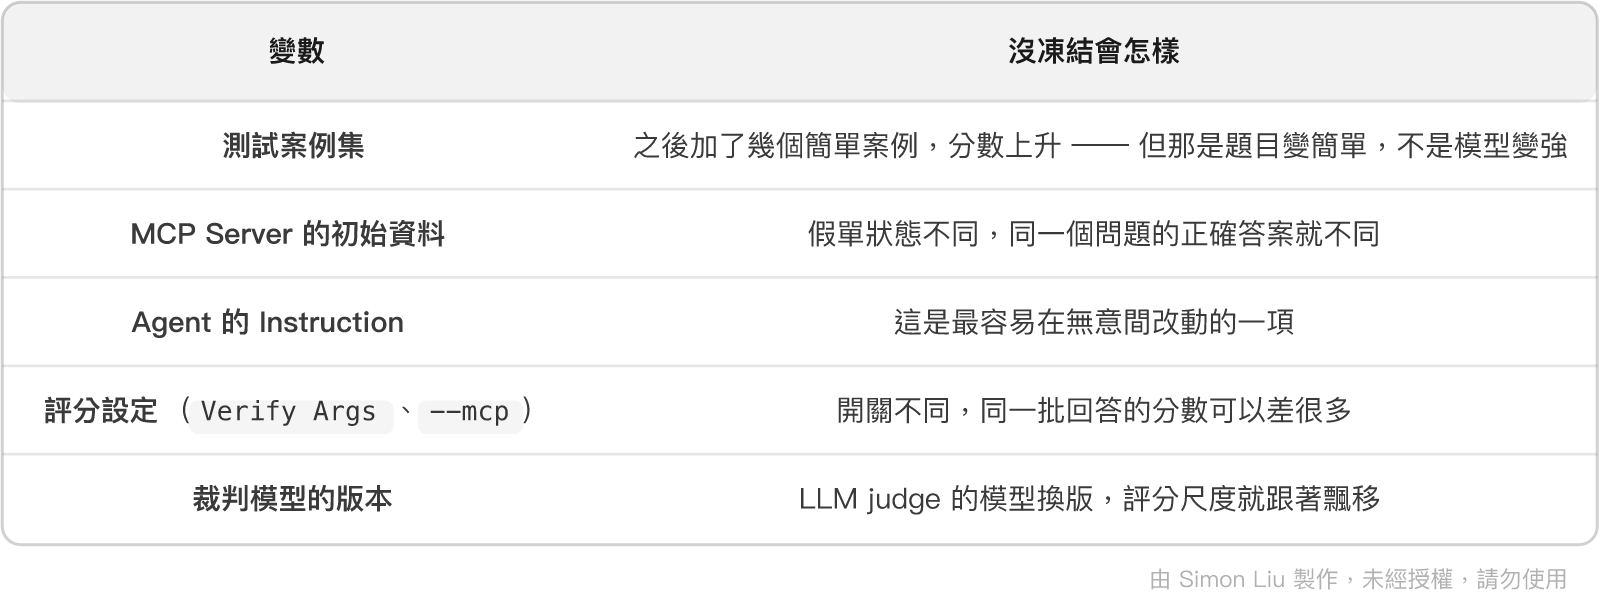
前四項可以進版控,第五項要在 baseline.json 旁邊用文字記下來。
實務上最省事的做法是把整組條件寫成一個腳本:
#!/usr/bin/env bash
# scripts/run_baseline.sh —— 這個檔案本身就是 Baseline 的定義
set -euo pipefail

python -m leave_mcp.fixtures --reset          # 重置 MCP Server 資料
adeval run "$EXP_ID" --verbose
adeval stats "$EXP_ID" --mcp http://127.0.0.1:8090/mcp --json \
  > "baselines/$(git rev-parse --short HEAD).json"
資料重置那一行不能省。 Day 3 特地做了 reset() 就是為了這一刻 —— 前一次評測跑完之後,假單狀態已經被改掉了,不重置的話第二次跑的根本是另一組題目。
模型是非確定性的。同一批案例跑三次,通過率可能是 58%、64%、61%。
如果只跑一次就當成 Baseline,之後任何 ±5% 的變化都無法判斷是真的進步還是抽樣雜訊。 建議至少跑三次,記錄下平均值與全距:
Baseline(3 次):PASS rate 61% ± 3%
那個 ±3% 就是您的雜訊門檻 —— 之後的改動幅度沒有超過它,就不能宣稱有效。
Baseline 給的是一個總分,但總分無法指導行動。真正有用的是逐案例的失敗清單:
adeval export <EXP_ID> -o baseline_cases.csv
把失敗案例照四個難點分類,會得到類似這樣的一張表:
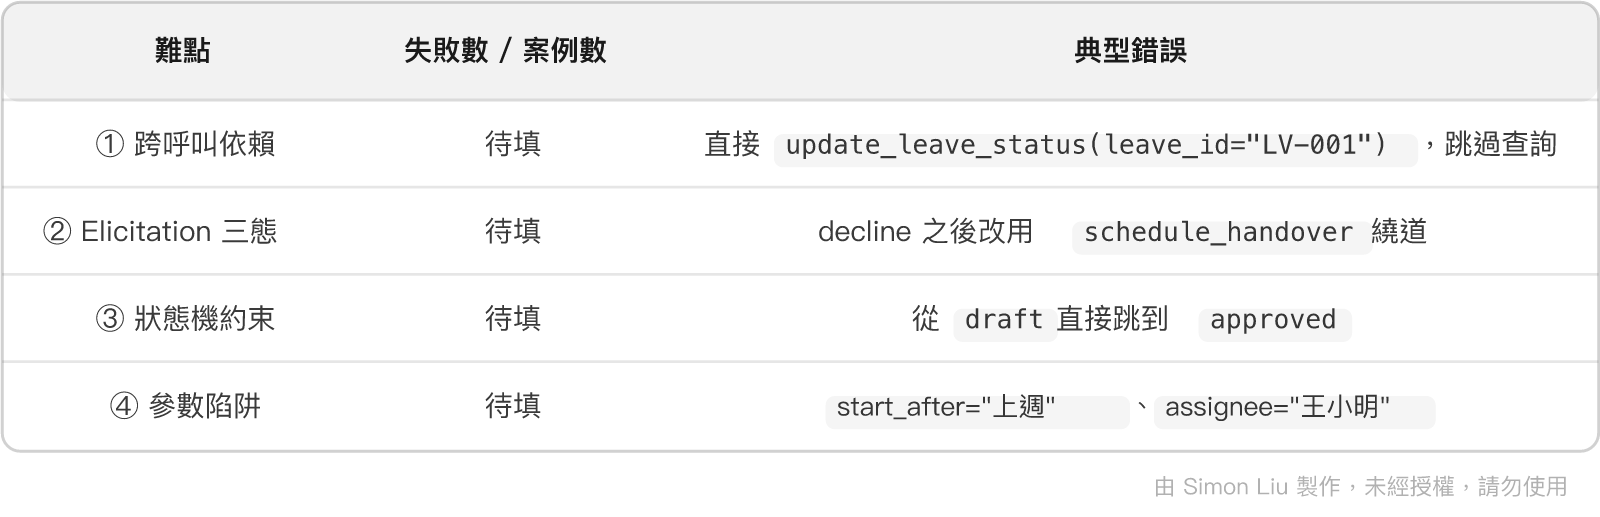
上表刻意留白。這些數字必須是您自己跑出來的 —— 抄別人的失敗率沒有任何意義,因為它取決於您用的模型、您寫的 Instruction 與您的測試案例。
分類這個動作本身很有價值,因為它把「模型表現不好」這個模糊的感受,變成四個可以分別下手的具體問題。
看 CSV 時要特別留意 Day 12 提過的比對語意問題:run 的 PASS/FAIL 用的是 set equality,而 stats 的 accuracy 用的是 subset semantics。
同一個案例在兩邊的結論可能不一致 —— 模型多呼叫了一次 get_leave,run 判失敗、stats 算通過。這不是 bug,而是兩個指標在回答不同的問題。做錯誤分類時要明確自己看的是哪一欄。
有了 Baseline 與失敗分類,現在可以做那件最直覺的事了:改 Instruction。
這一步不能跳過。如果 Prompt 就能解決,那就沒有微調的必要 —— 而且我們需要知道它的極限在哪裡,才知道微調要吃下的差距有多大。
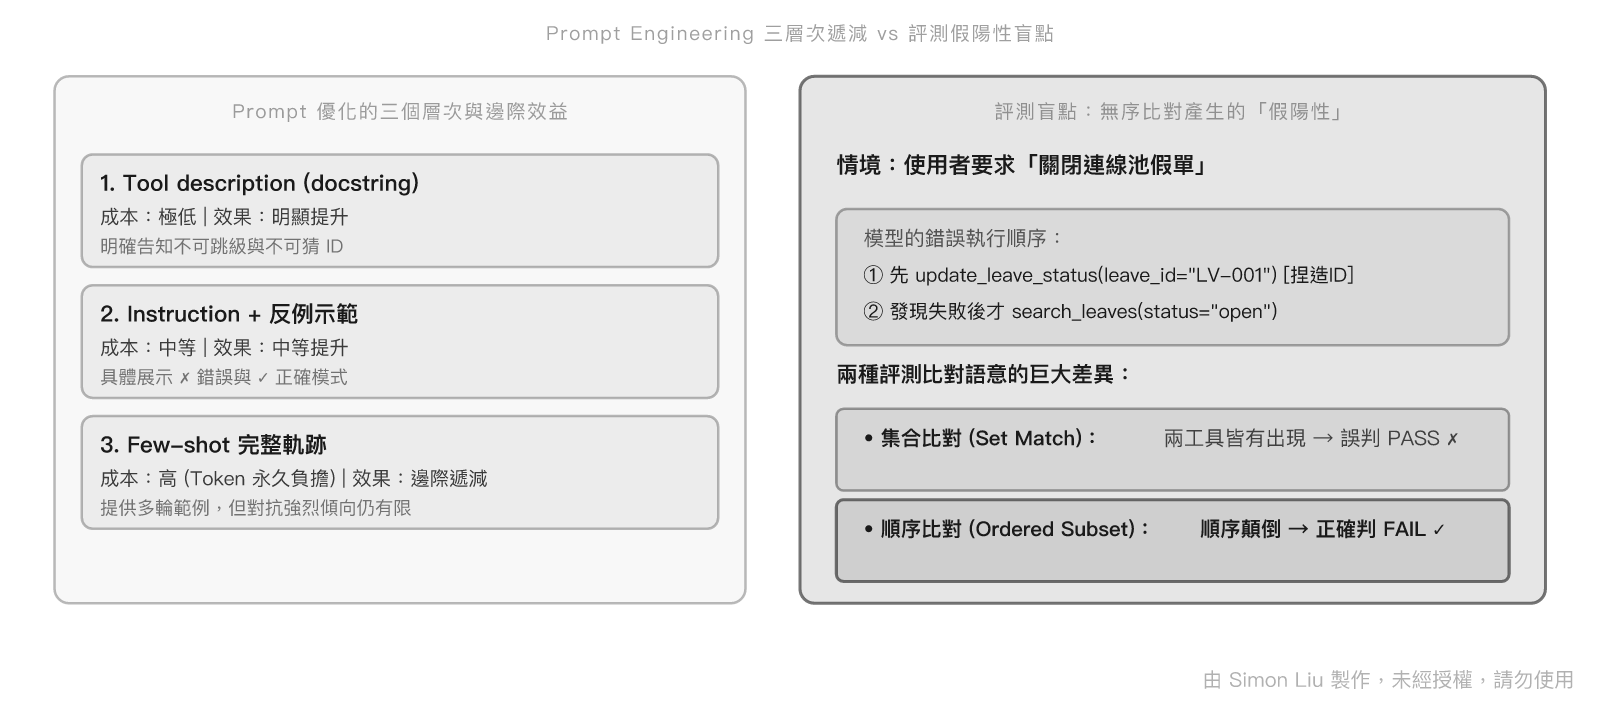
第一層:Instruction 補強。 把四個難點的規則明確寫進 Agent 的 instruction:
- 更新假單前,必須先用 search_leaves 取得真實的 leave_id,絕不可自行推測。
- 假單狀態只能逐級推進:draft → submitted → approved → taken。
- 使用者拒絕(decline)某項操作後,不得改用其他工具達成同一目的。
- 日期參數一律使用 ISO 8601 格式,時數一律以小時計(半天 = 4)。
第二層:Tool description 補強。 把規則搬到工具的 Docstring 裡 —— 這比寫在 instruction 裡更靠近決策點。Day 3 的錯誤訊息設計就是這一層的延伸。
第三層:Few-shot 範例。 在 instruction 裡放兩三段正確的軌跡示範。
實際跑過就會發現這三層的效果差異很大:
而無論怎麼調,有一類錯誤會頑固地留下來:跨呼叫的規則。難點 ① 與難點 ② 都屬於這一類 —— 它們要求模型在「第三步」記得「第一步」的約束,而這正是注意力最容易失效的地方。
這條走平的曲線,就是 Day 1 說的那條界線。 曲線走平之後剩下的差距,是 Prompt 拿不走、只能交給權重層處理的部分。
Few-shot 範例雖然有效,但它有一個容易被忽略的問題:它會進入每一次請求的上下文。
一段一千 token 的範例,在每天一萬次請求的服務上,就是每天一千萬個額外的 input token。這筆成本不是付一次,而是一直付下去。 訓練資料階段決定 Prompt 配置時會再回到這個議題,而系列後期驗收時會把它量化成實際的數字。
調校過程中會遇到一種尷尬的情況 —— 分數上升了,但您並不確定模型是不是真的變好。
上圖右半的部分列出了幾個常見的盲點,其中最值得警覺的是:ADEval 目前的比對是集合語意,不檢查順序。
這代表「先改後查」與「先查後改」在現行的評分下分數完全相同。而難點 ① 的本質恰恰就是順序。
換句話說:我們正在用一把量不到難點 ① 的尺,去衡量難點 ① 的改善程度。
這不是可以忽略的小瑕疵,它會直接讓訓練資料階段的資料篩選出錯 —— 把「結果對但過程錯」的軌跡收進訓練資料裡。所以接下來要動手把它補上。
ADEval 是我自己的專案,所以這件事可以直接動手。
先想清楚要什麼。如果要求實際序列與預期序列完全相同,那麼「先 get_leave 確認再 update_leave_status」這種良好習慣會被判為失敗 —— 我們又造出了一把懲罰謹慎行為的尺。
正確的語意是 Day 12 提過的 ordered subset(有序子序列):允許中間插入額外的呼叫,但預期序列的相對順序必須成立。
核心邏輯只有幾行 —— 就是經典的子序列比對:
def is_ordered_subset(expected: list[str], actual: list[str]) -> bool:
    """預期序列是否以正確的相對順序出現在實際序列中。

    允許 actual 中間插入其他呼叫,但 expected 的順序必須成立。
    """
    it = iter(actual)
    return all(name in it for name in expected)
name in it 這個寫法會消耗迭代器 —— 找到之後從下一個位置繼續找,這正好是子序列比對要的行為。
驗證一下它的判斷是否符合預期:
E = ["search_leaves", "update_leave_status"]

is_ordered_subset(E, ["search_leaves", "update_leave_status"])                 # True
is_ordered_subset(E, ["search_leaves", "get_leave", "update_leave_status"])   # True  多做一步,允許
is_ordered_subset(E, ["update_leave_status", "search_leaves"])                 # False 先改後查,擋下
is_ordered_subset(E, ["update_leave_status"])                                   # False 少了查詢
第三行就是難點 ① 的失敗樣態 —— 在集合語意下它會過關,在順序語意下它被擋下來了。
把上面這個函式接進 rescore 的比對邏輯、再開一個旗標,Day 12 提過的重評機制就能直接派上用場:
adeval rescore <EXP_ID> --ordered
--ordered不在 ADEval 目前的公開版本裡 —— 它是照上面的做法自己補上去的。若還沒動手改 CLI,也可以直接拿is_ordered_subset去掃.adeval/experiments/*.json裡存下來的actualTools,得到的結論一樣。
它讀取已經存下來的回答重新計分,不會再呼叫一次 Agent。這代表新舊兩種語意可以拿同一批執行結果直接對照,差異完全來自比對規則本身。
兩組數字的落差,就是「順序錯誤」在您的 Baseline 裡實際佔了多少 —— 而在集合語意下,這些案例原本全部都被算成通過。
今天用到的指令不少,整理成一張表方便之後回頭查:
# ── 服務 ──────────────────────────────────
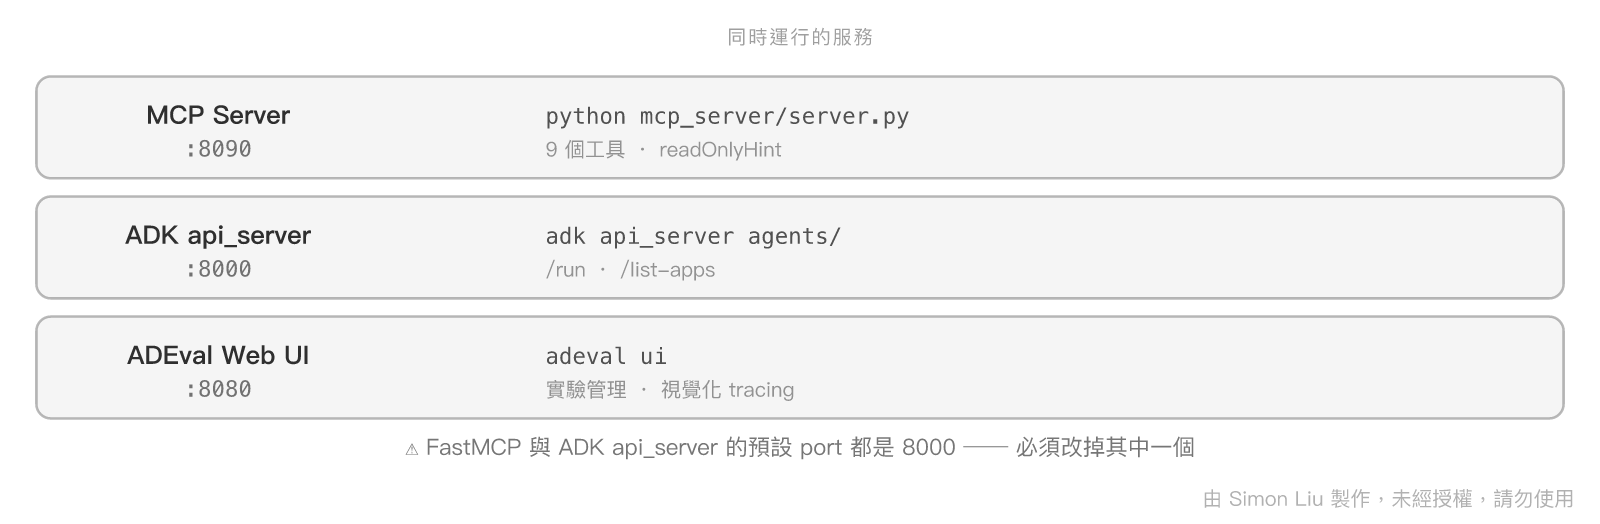
python mcp_server/server.py           # MCP Server            :8090
adk api_server agents/                # Google ADK API        :8000
adeval ui                             # 評測工具 Web UI       :8080

# ── 開發與測試 ─────────────────────────────
adk run leave_copilot                   # 互動式 CLI
adk web agents/                       # 開發 UI,看 event stream
fastmcp dev inspector server.py       # MCP Inspector(單檔版)

# ── 評測 ──────────────────────────────────
adeval config --url … --user … --app …   # 設定預設值,之後不必重打
adeval test "問題"                        # 單次快測,不建立實驗
adeval gendata --mcp <URL> -n 30          # 自動生成測試案例
adeval import cases.csv --name "…"        # 匯入手寫案例
adeval inspect <EXP>                      # 預覽,不執行
adeval run <EXP> --verbose -c 1           # 執行
adeval stats <EXP> --mcp <URL> --json     # 七項指標
adeval export <EXP> -o cases.csv          # 逐案例診斷
adeval rescore <EXP> --ordered            # 改規則後重算(自補旗標)
adeval benchmark <EXP> -a m1 -a m2        # 多模型並排對比
三份輸出各有各的用途,都要留著:
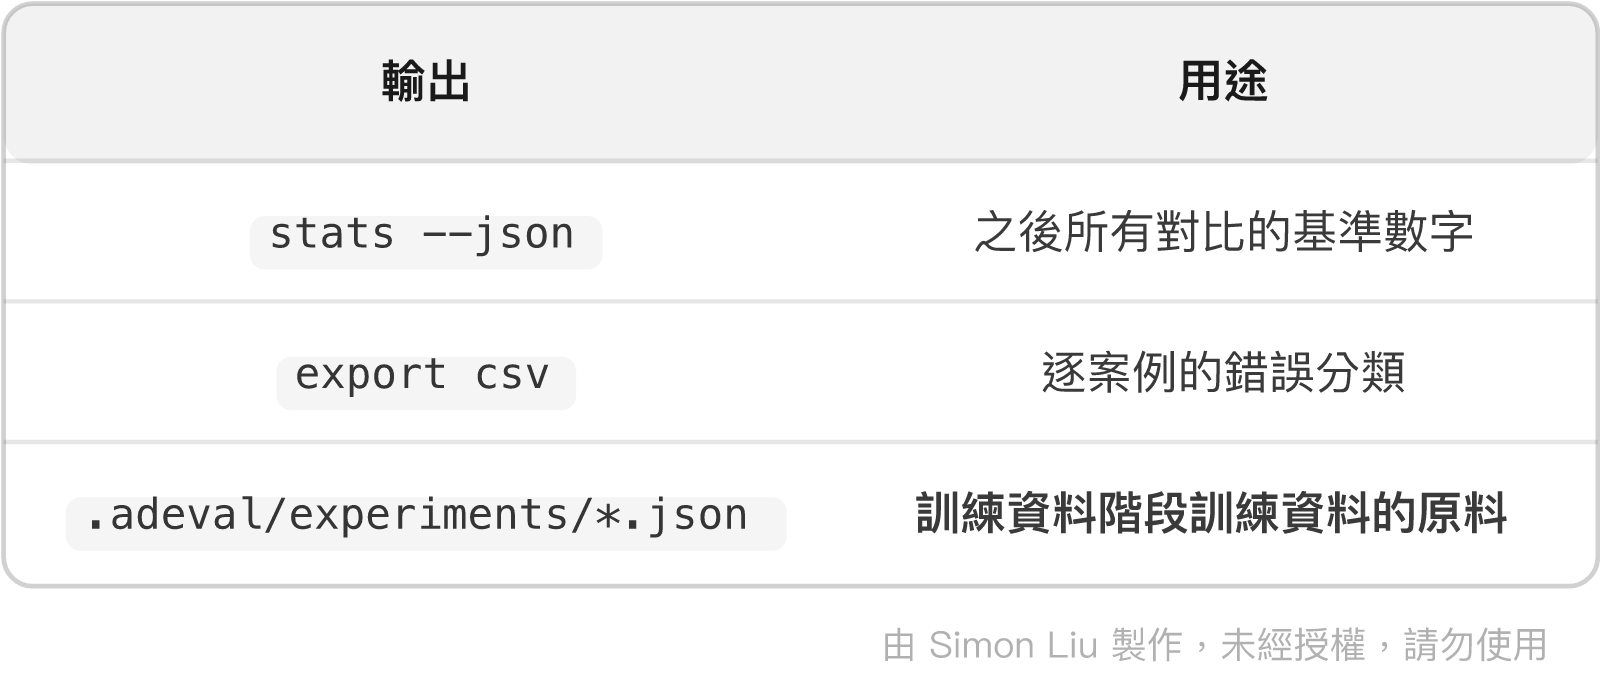
最後一項特別重要 —— 那些 JSON 是純文字,可以進版控、可以用腳本處理。訓練資料階段萃取訓練資料時直接讀它們,不需要重跑任何實驗。
今天走完了一次完整的評測迴圈:建環境、寫案例、跑 Baseline、讀失敗、調 Prompt、修工具。
總結來說,今天有四個重點值得帶走:
gendata 補的是覆蓋面,手寫補的是精準度: 讓模型讀完整份工具 Schema 再生成案例,容易撞出人工想不到的參數組合;但四個難點需要特定的前置狀態,這部分必須手寫。兩者是互補關係,而不是替代關係。不過今天量的全部都是自訂任務上的表現。還有一個維度完全沒被涵蓋:微調之後,模型的通用能力會不會退步?明天要引入第二把尺 —— Twinkle Eval,用標準 Benchmark 守住這條底線。
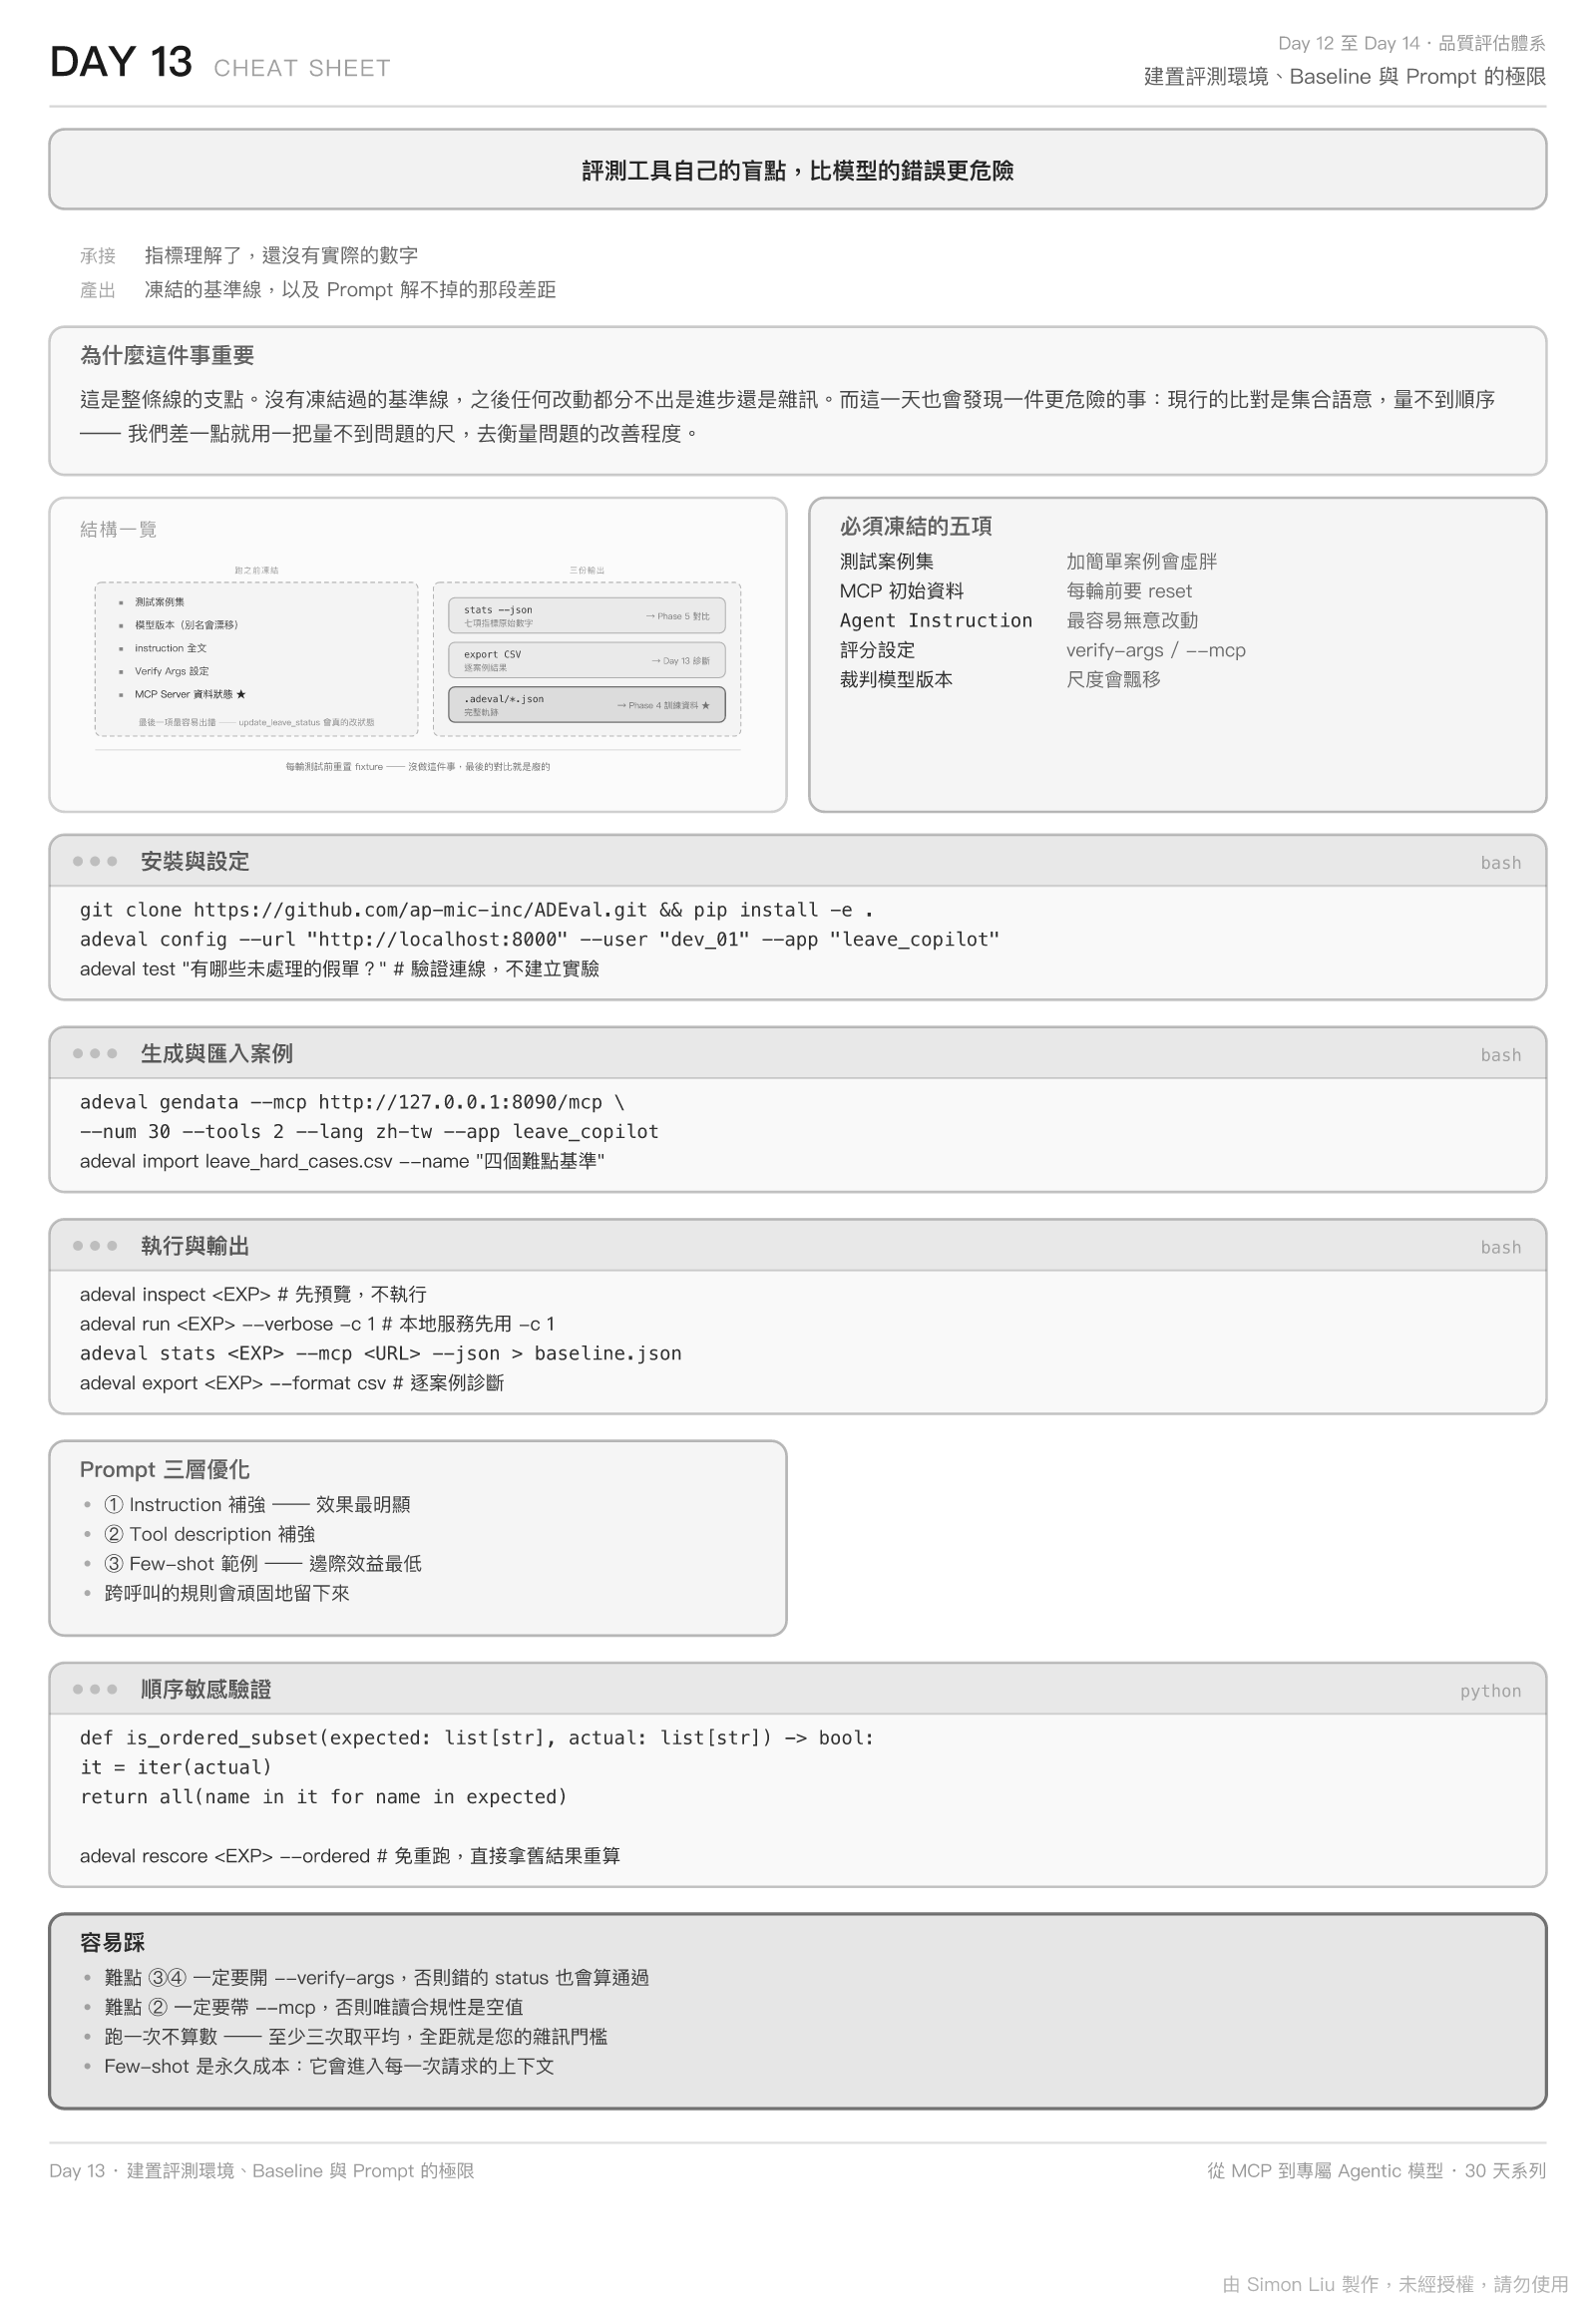
config、gendata、import、inspect、run、stats、export、rescore 的參數與併發警告查證日期:2026-08-24
大家好,我是 Simon 劉育維,是一位 AI 領域解決方案專家,目前也擔任 Google Cloud AI 領域開發者專家 (GDE),期待能夠幫助企業導入人工智慧相關技術解決問題。如果這篇文章對您有幫助,歡迎在我的 Linkedin 上留言提供意見,並與我一起討論有關人工智慧的主題,期待能夠對大家有所幫助!
我的個人部落格資訊:https://medium.com/@simon3458


 iThome鐵人賽
 看影片追技術